AI 학습 데이터 논란은 모델 학습 과정에서 창작자의 사전 동의 및 보상의 부재, 생계 위협, 화풍 모방 문제 등이 복합적으로 작용하며 전면화되었습니다.
미국과 영국 법원 등에서 대규모 합의와 기각 판결이 교차하며 법적 기준이 정립되는 과정에 있으며, 플랫폼의 옵트아웃 도입과 EU AI법 등 제도적 대응도 활발히 논의되고 있습니다.
제도가 정착되기 전까지 창작자는 자작품의 학습 데이터 포함 여부 조회, 플랫폼 이용약관 확인, 워터마크 활용 등을 통한 개별적 대비가 권장됩니다.
이 글의 순서
창작자들이 반발하는 핵심 이유
최근 몇 년 사이 생성형 AI 서비스가 빠르게 늘어나면서, 그 뒤편에서 조용히 커지던 갈등이 전면으로 드러나고 있습니다. AI 학습 데이터 논란은 AI 모델이 글, 그림, 사진, 코드 같은 콘텐츠를 어떻게 모아 학습했는지, 그리고 그 과정에서 원작자의 권리를 얼마나 존중했는지를 둘러싼 다툼입니다. 창작자 입장에서는 자신이 몇 년에 걸쳐 쌓아온 작품이 동의나 보상 없이 모델 학습에 쓰였다는 점이, AI 기업 입장에서는 방대한 데이터 없이는 지금 수준의 모델을 만들기 어렵다는 현실이 서로 충돌하고 있습니다.
창작자들이 느끼는 불만은 단순히 “내 그림체를 베꼈다”는 감정적인 문제를 넘어섭니다. 실질적으로는 다음과 같은 지점에서 갈등이 벌어집니다.
첫째, 동의 절차의 부재입니다. 다수의 초기 학습 데이터셋은 웹에 공개된 이미지와 글을 대규모로 수집하는 방식으로 만들어졌는데, 이 과정에서 개별 작가나 작가에게 사전 동의를 구하는 절차가 거의 없었습니다. 작품을 인터넷에 올렸다는 사실만으로 학습에 활용된 것이 과연 적절한지가 쟁점입니다.
둘째, 생계와 직결되는 문제라는 점입니다. 일러스트레이터, 사진작가, 번역가, 성우 등 창작 노동으로 소득을 얻는 직군은 AI가 비슷한 결과물을 더 빠르고 저렴하게 만들어내면서 일감 자체가 줄어드는 상황을 체감하고 있습니다. 데이터로 쓰인 것과 일자리를 위협받는 것이 맞물려 반발이 커지는 구조입니다.
셋째, 스타일 모방과 정체성의 문제입니다. 특정 작가의 화풍이나 문체를 거의 그대로 재현하는 프롬프트가 공개적으로 공유되는 사례가 늘면서, 저작권법이 명확히 다루지 않는 “스타일”의 영역까지 침해로 느껴지는 경우가 생기고 있습니다.
실제로 어떤 법적 다툼이 있었나
이 갈등은 추상적인 논쟁에 머물지 않고 실제 소송과 판결로 이어지고 있습니다.
미국에서는 작가들이 제기한 저작권 소송에서 앤트로픽이 거액의 합의금을 지급하기로 하면서 미국 저작권 소송 역사상 최대 규모의 합의로 평가받는 결과가 나왔습니다. 다만 합의에 동의하지 않고 별도로 빠져나온 일부 작가들이 새로운 소송을 제기하는 등, 하나의 합의로 논란이 완전히 정리되지는 않았다는 점도 함께 짚어볼 부분입니다. 이는 합의금을 받는다고 해서 데이터 수집 방식 자체의 정당성 문제가 해소되는 것은 아니라는 창작자 측 시각을 보여줍니다.
Judge approves record $1.5 billion AI copyright settlement involving Anthropic에 따르면 이 합의는 미국 저작권 소송 중 최대 규모로 법원의 승인을 받았으며, Cruz v. Anthropic 관련 보도는 합의에서 빠져나온 작가 28명이 별도로 새 소송을 낸 사실을 전하고 있습니다.
이미지 쪽에서는 게티이미지가 스테이블 디퓨전을 만든 스태빌리티 AI를 상대로 영국에서 제기한 소송이 주목받았습니다. 영국 법원은 저작권 관련 핵심 주장을 대부분 받아들이지 않으며 스태빌리티 AI에 유리한 판단을 내렸는데, 이는 학습 데이터 자체를 복제·저장하지 않고 패턴만 학습하는 방식이 기존 저작권법의 틀로는 쉽게 침해로 규정되지 않는다는 점을 보여준 사례로 평가받습니다.
Judge in London Dismisses AI Copyright Claims in Getty’s Lawsuit는 런던 법원이 게티이미지의 저작권 침해 주장을 기각한 판결 내용을 전하고 있습니다.
이처럼 소송 결과는 사안마다, 국가마다 다르게 나오고 있어서 “AI 학습은 무조건 침해다” 또는 “AI 학습은 무조건 합법이다”라고 단정하기 어려운 상황입니다.
플랫폼과 제도는 어떻게 대응하고 있나
논란이 커지자 AI 기업과 각국 제도도 나름의 대응책을 내놓고 있습니다.
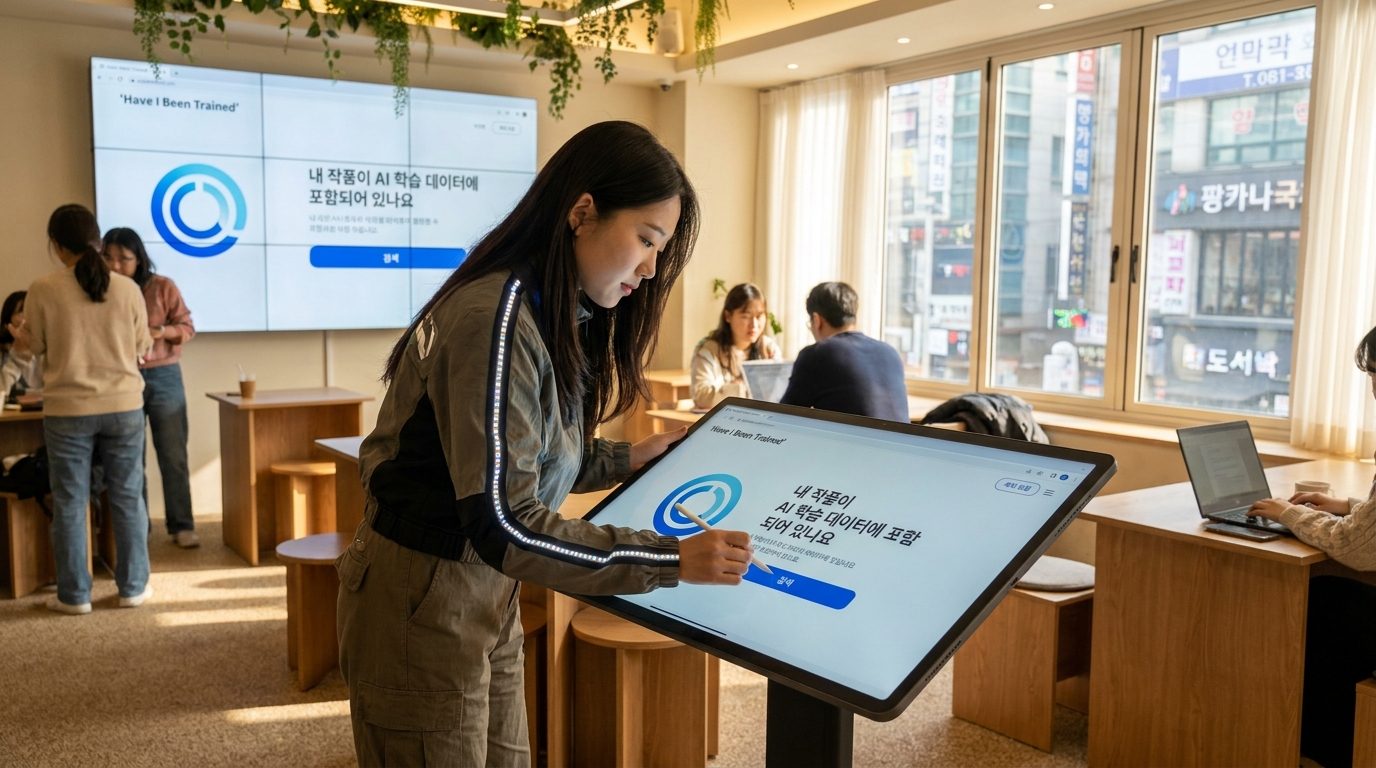
일부 AI 이미지 생성 기업은 창작자가 자신의 작품을 학습 데이터에서 제외해 달라고 요청할 수 있는 옵트아웃 절차를 마련했습니다. Spawning이 운영하는 “Have I Been Trained” 같은 서비스는 작가가 자신의 이미지가 특정 학습 데이터셋에 포함돼 있는지 검색하고, 포함돼 있다면 이후 수집에서 제외해 달라고 요청하는 창구로 쓰입니다. 다만 이미 만들어진 기존 모델에서 특정 데이터를 완전히 지우는 것은 기술적으로 간단하지 않다는 한계도 함께 지적됩니다.
유럽연합은 AI법을 통해 범용 AI 모델을 만드는 기업에 학습에 사용한 콘텐츠의 저작권 현황을 파악하고, 저작권자가 거부(옵트아웃) 의사를 밝힌 콘텐츠를 존중하는 정책을 마련하도록 하는 투명성 의무를 부과하는 방향으로 움직이고 있습니다. 다만 이 같은 제도가 실제로 어떻게 집행되고 위반 시 어떤 제재가 따르는지는 계속 구체화되는 단계이므로, 최신 시행 상황은 공식 발표를 통해 확인하는 것이 정확합니다.
일부 스톡 이미지 플랫폼은 자사 플랫폼에 올라온 이미지를 AI 학습에 제공한 대가로 기여자에게 수익을 배분하는 기금을 운영하는 방식으로, 반발을 줄이고 합법적인 데이터 확보 경로를 만들려는 시도를 하고 있습니다.
창작자가 지금 할 수 있는 실질적인 대응
제도가 완전히 정리되지 않은 상황에서 창작자가 할 수 있는 현실적인 대응은 다음과 같습니다.
먼저 자신의 작품이 어떤 학습 데이터셋에 포함돼 있는지 확인하는 것부터 시작할 수 있습니다. 앞서 언급한 옵트아웃 검색 도구를 활용하면 최소한 어떤 데이터셋에 작품이 포함돼 있는지 가늠할 수 있습니다.
다음으로, 작품을 공개하는 플랫폼의 이용약관을 꼼꼼히 확인하는 습관이 필요합니다. 일부 플랫폼은 업로드한 콘텐츠를 AI 학습에 활용할 수 있다는 조항을 약관에 포함하고 있어서, 어디에 작품을 올리느냐에 따라 데이터 활용 가능성이 달라집니다.
또한 메타데이터나 워터마크를 활용해 작품의 출처를 명확히 표시해 두면, 추후 무단 활용 여부를 확인하거나 문제를 제기할 때 근거 자료로 쓸 수 있습니다.
마지막으로, 소속 업계 단체나 저작자 단체가 진행하는 집단 대응이나 소송 동향을 꾸준히 살펴보는 것도 중요합니다. 개인이 혼자 대응하기 어려운 사안인 만큼, 비슷한 입장의 창작자들과 정보를 공유하는 것이 실질적인 도움이 됩니다.
앞으로 지켜봐야 할 지점
AI 학습 데이터를 둘러싼 논란은 단일 판결이나 합의로 끝나는 문제가 아니라, 여러 나라의 법원과 입법 기관이 각자 다른 결론을 내놓으며 당분간 계속 이어질 가능성이 큽니다. 창작자 입장에서는 자신의 권리를 지키기 위한 절차를 알아두는 것이, AI 서비스를 이용하는 입장에서는 결과물의 활용 범위와 관련 분쟁 가능성을 함께 염두에 두는 것이 필요합니다. 구체적인 계약이나 침해 여부를 다투어야 하는 사안이라면, 일반적인 정보만으로 판단하기보다 저작권 관련 법률 전문가와 상담해 개별 상황에 맞는 조언을 받는 것이 안전합니다.
참고자료
- Judge approves record $1.5 billion AI copyright settlement involving Anthropic
- Cruz v. Anthropic: 28 Authors Who Opted Out of the $1.5B Settlement File New Copyright Suit Against Claude’s Developer
- Judge in London Dismisses AI Copyright Claims in Getty’s Lawsuit
자주 묻는 질문
옵트아웃(Opt-out)을 요청하면 기존 AI 모델에서 내 데이터가 바로 삭제되나요?
이미 학습이 완료된 기존 AI 모델 내부에서 특정 수집 데이터만 기술적으로 골라내어 완전히 지우는 것은 어려운 것으로 알려져 있습니다. 따라서 옵트아웃 절차는 주로 향후 새롭게 수집되거나 만들어질 데이터셋 및 모델 학습 대상에서 제외해 달라고 요청하는 창구로 활용됩니다.
특정 작가의 이름이나 화풍을 지정하여 생성하도록 하는 프롬프트는 법적으로 제재할 수 있나요?
현행 저작권법은 구체적인 표현물 자체를 보호하며, 추상적인 ‘화풍’이나 ‘스타일’ 그 자체는 저작권 보호 대상에 포함되지 않는 경우가 많습니다. 이에 따라 특정 스타일 모방 프롬프트의 직접적인 제재 여부는 법률상 명확한 기준이 정립되는 과정에 있습니다.
작품에 메타데이터나 워터마크를 남기는 것이 무단 학습 방지에 도움이 되나요?
워터마크나 메타데이터가 대규모 자동 수집 알고리즘을 물리적으로 완전히 차단하지는 못하더라도, 향후 무단 수집 및 활용 여부를 입증하거나 저작권 출처를 명확히 하는 근거 자료로서 대응 시 유용하게 쓰일 수 있습니다.